最近,在 github 看到了一个名为 FramePack 的图生视频项目,基于预测神经网络结构,可以在资源有限的设备上生成高质量的视频。它通过将上下文压缩成固定长度,使得生成任务的工作量与视频长度无...
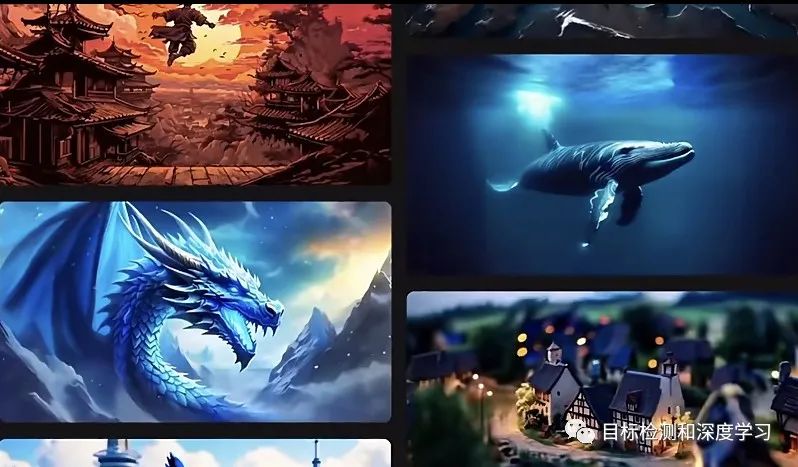
Stable Diffusion是2022年发布的深度学习文本到图像生成模型。文本到图像生成模型是一种机器学习模型,一般以自然语言描述为输入,输出与该描述相匹配的图像。这种模型的开发始于2010年代中...
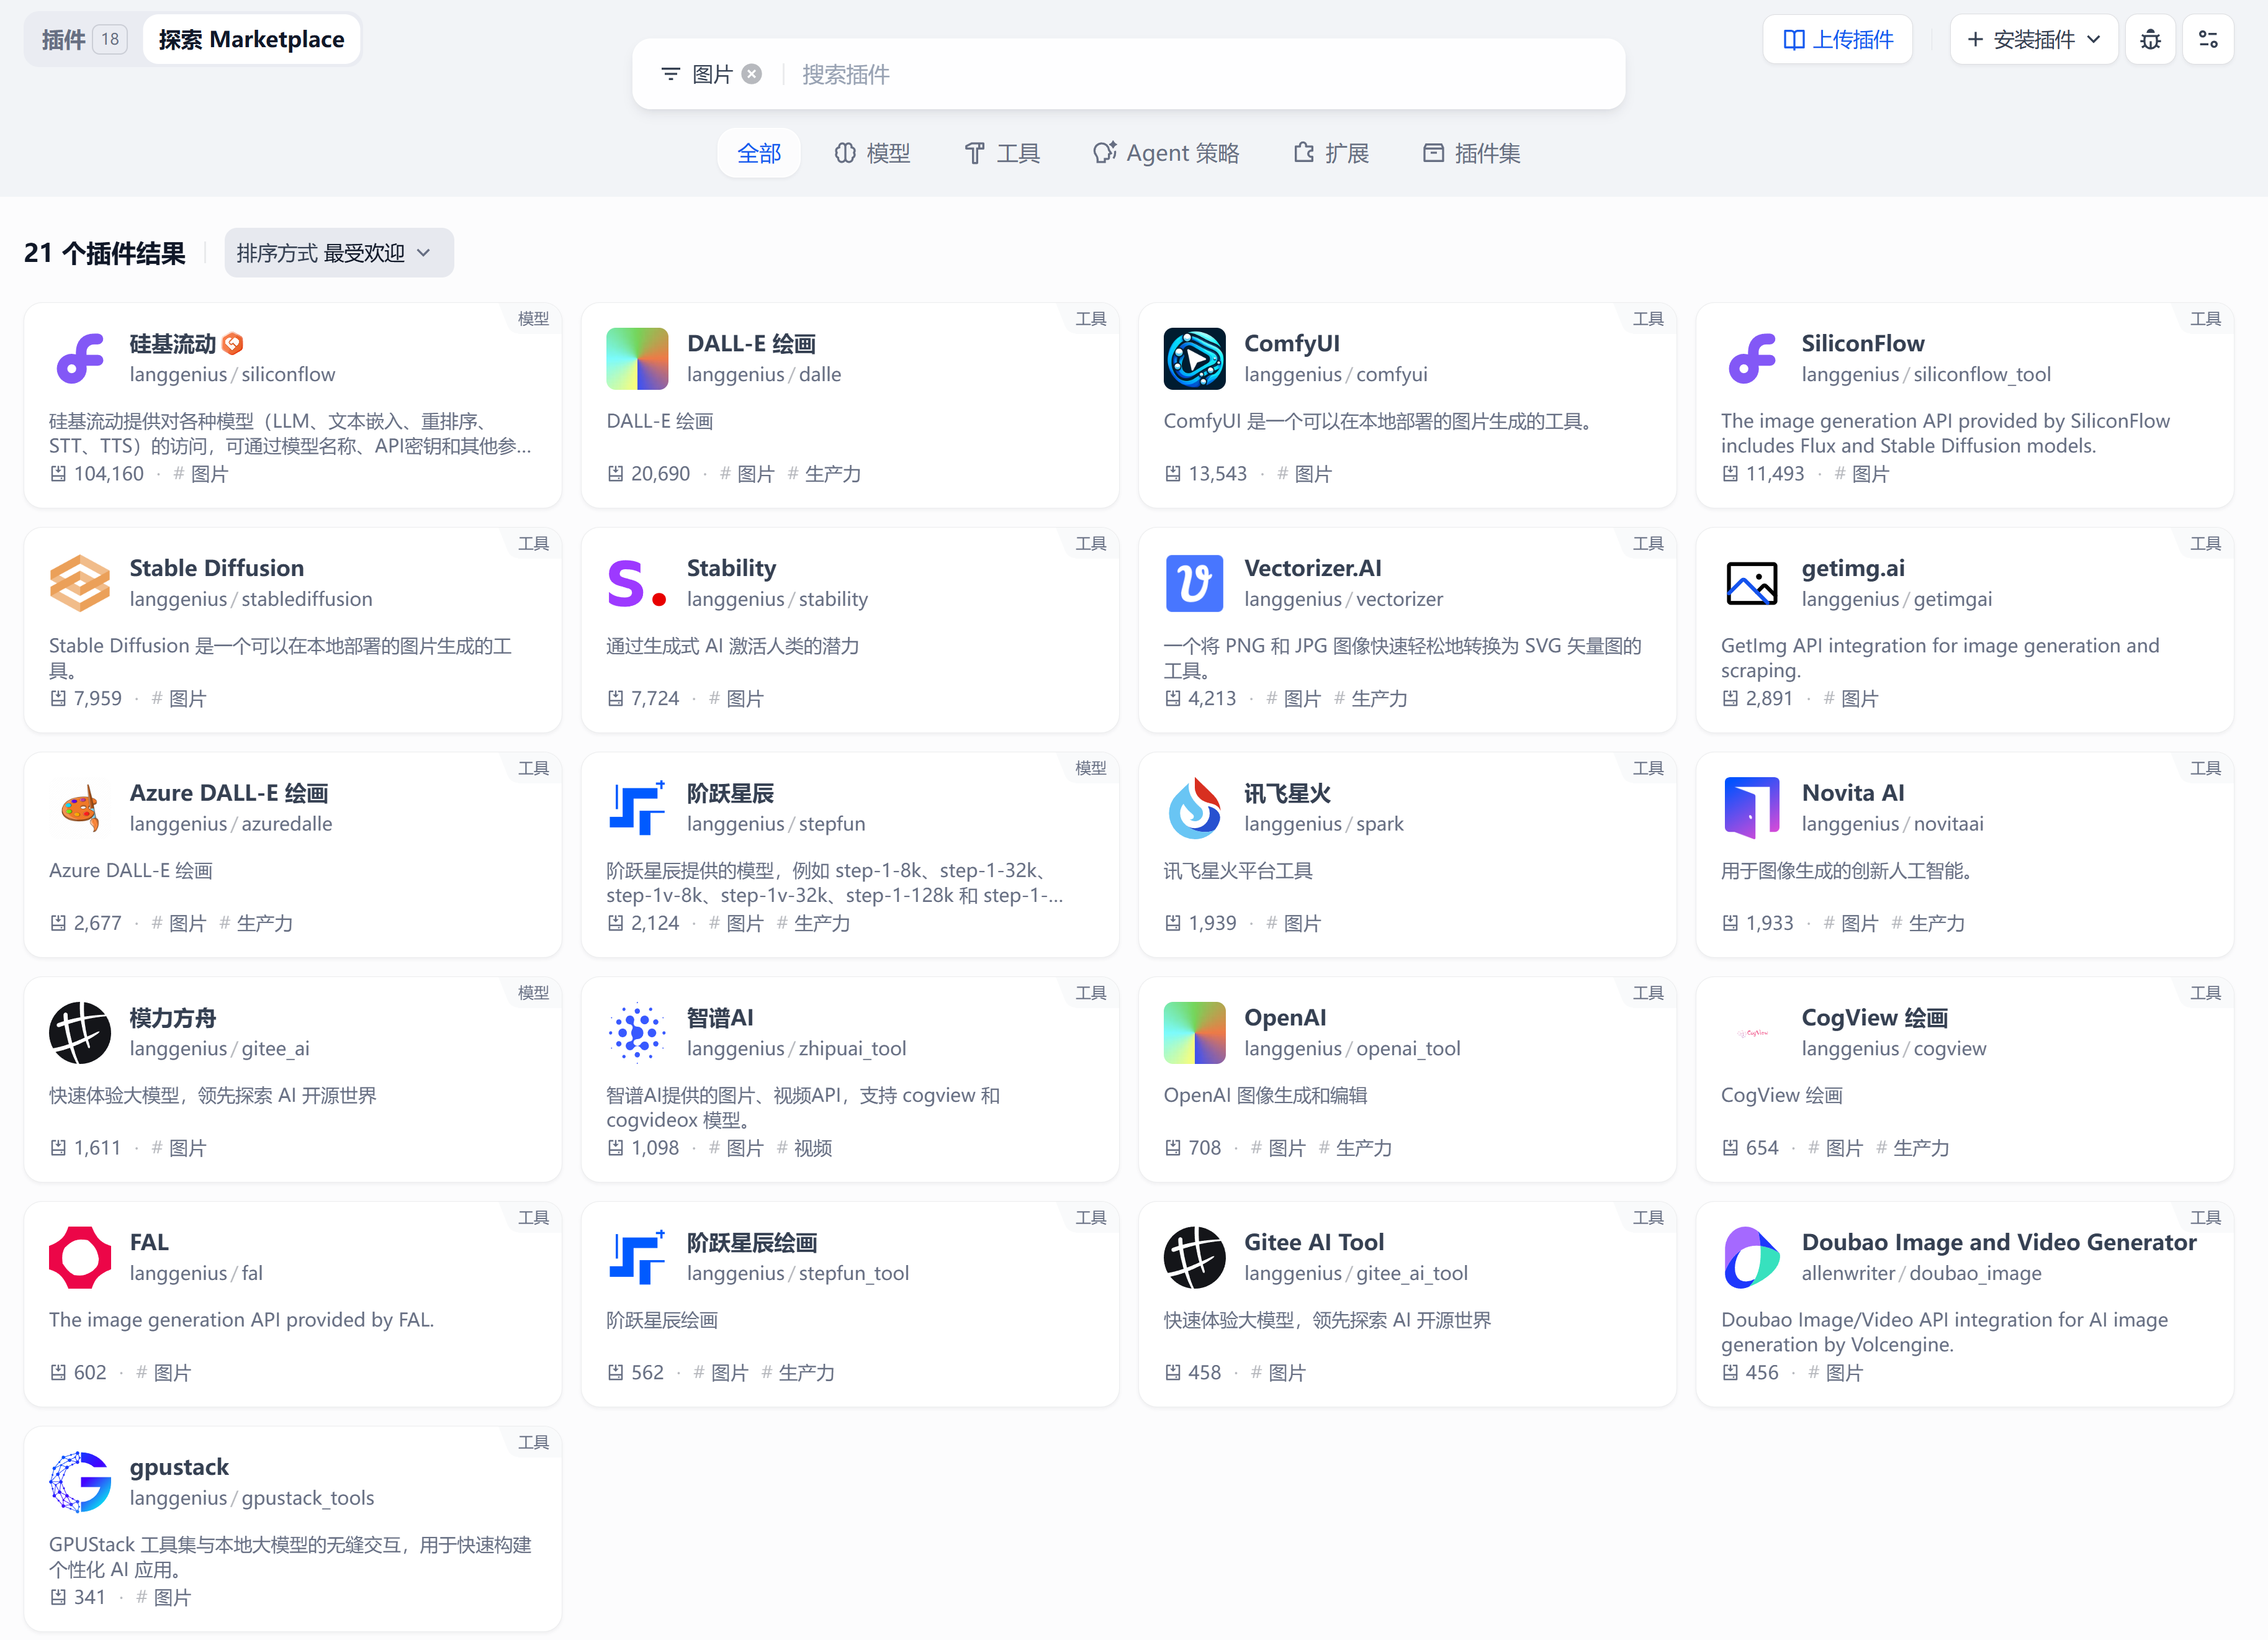
使用 Dify 搭建 AI 图片生成助手并不是什么难事,而且不需要你会编程知识,也能轻松实现。但是,Dify 在搭建 AI 图片生成助手的过程中会遇到很多坑,例如以下这些:有些组件随着时间的推移,已经...
通过 canvas 将 svg 元素生成图片的形式,其中图片的大小取决于 svg 元素的复杂度。const svgString = new XMLSeriali...
StableVideoDiffusion效果不错,可自动判断需要出现动态的位置,并且自动判断应该如何运动动。同时也不会产生涉及到复杂的内容(比如人脸)的时候画面崩坏的问题,非常稳定。...
用ControlNet结合Mov2Mov插件生成新的视频。虽然它能够快速的对视频中的人物进行转换,但是还存在难以解决的闪烁问题。...
一、AI智能体的定义与核心内涵AI智能体(Agent)是能够感知环境、自主决策并执行动作的智能实体,其核心特征在于“自主性”“反应性”“目标导向性”与“社会交互性”。与传统程序不同,AI智能体通过传感...
RAG 的关键其实就在检索这一步:检索质量好不好,很大程度上取决于怎么切分和存储文档——也就是分块(Chunking)这个看起来不起眼的环节。固定分块、递归分块、语义分块、结构化分块、延迟分块,每种方...
一、技术原理1.1 架构设计理念解析轻量级RAG系统的核心设计理念是"检索增强+轻量化推理"的双重优化。传统RAG架构依赖大型语言模型(...
为什么RAG如此重要大模型的训练数据是有截止日期的,而且对于企业私有知识一无所知。RAG(检索增强生成) 是目前解决这个问题最主流、最实用的方案。过去半年,我先后在3个项目上落地了RAG技术,从最基础...